


最近节日
正在加载日历...----
布隆过滤器能够实现使用较少的空间来判断一个指定的元素是否包含在一个集合中
布隆过滤器能够实现使用较少的空间来判断一个指定的元素是否包含在一个集合中
布隆过滤器并不保存这些数据,所以只能判断是否存在,而并不能取出该元素
也就是说,凡是要判断一个元素是否在一个集合中的操作,都可以使用它
常规的检查一个元素是否在一个集合中的思路是遍历集合,判断元素是否相等,这样的查询效率非常低下
要保证快速确定一个元素是否在一个集合中,我们可以使用HashMap
因为HashMap内部的散列机制,保证更快更高效的找到元素
所以当数据量较小时,用HashMap或HashSet保存对象,然后使用它进行判断元素是否存在,是一个不错的方法
但是如果数据量太大,每个元素都要生成哈希值来保存,我们也要依赖哈希值来判断是否存在,一般情况下,我们为了保证尽量少的哈希值冲突,需要8字节哈希值做保存
long的取值范围:
如果有上亿条数据,每条8字节计算结果需要过G的内存,随着内存数增长,这个数字可能更大
所以Hash散列或类似算法可以保证高效判断元素是否存在,但是消耗内存较多
所以我们使用布隆过滤器实现高效判断是否存在的同时,还能节省内存
但是布隆过滤器的算法天生会有误判情况,需要能够容忍,才能使用
布隆过滤器误判效果:
过短的布隆过滤器如果保存很多的数据,可能造成二进制位置值都是1的情况,一旦发生这种情况,布隆过滤器就会判断任何元素都在该集合中,布隆过滤器就会失效
所以我们要给布隆过滤器一个合适的大小,才能让他更好的为程序服务
优点
空间效率和查询效率高
缺点
我们在启动布隆过滤器时,需要给它分配一个合理大小的内存
这个大小应该满足:内存占用在一个可接受范围、不能有太高的误判率(<1%)
内存约节省,误判率越高;内存越大,误判率越低
计算误判率的公式
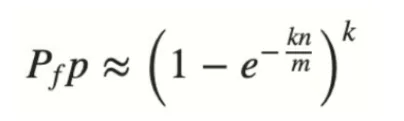
上面是根据误判率计算布隆过滤器长度的公式
n是已经添加元素的数量
k哈希的次数
m布隆过滤器的长度(位数的大小)
计算结果就是误判率
如果我们已经确定可接受的误判率,就可以计算布隆过滤器的长度
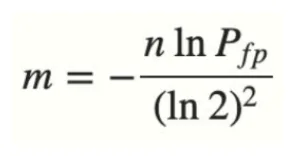
布隆过滤器计算器
启动虚拟机,安装了一个特殊版本的Redis,内置了lua脚本,支持布隆过滤器的方法
使用stock-webapi模块进行测试
添加依赖
<!--添加redis依赖--> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-redis</artifactId> </dependency>spring: redis: host: 192.168.66.227 port: 6379 password:测试代码
操作布隆过滤器有一个专门的类
实现对布隆过滤器的新增元素,检查元素等方法的实现
在酷鲨前台大项目中的seckill-webapi下的utils包里
RedisBloomUtils类复制到需要使用布隆过滤器的项目中
原有的代码可以先注释起来
@Autowired private RedisBloomUtils redisBloomUtils; @Override public void execute(JobExecutionContext jobExecutionContext) throws JobExecutionException { //具体要执行的任务--输出当前时间// System.out.println("=============="+LocalDateTime.now()+"==============");// StockReduceCountDTO stockReduceCountDTO = new StockReduceCountDTO();// stockReduceCountDTO.setCommodityCode("PU201");// stockReduceCountDTO.setReduceCount(-1);// stockService.reduceCommodityCount(stockReduceCountDTO); //先简单发送一个字符串 //convertAndSend([交换机名称],[路由key的名称],[要发送的消息])// rabbitTemplate.convertAndSend(// RabbitMQConfig.STOCK_EX,RabbitMQConfig.STOCK_ROUT,"消息:执行减少库存的操作"); // 先定义向布隆过滤器中保存的元素 String[] colors={"red","green","yellow","pink","blue"}; //向布隆过滤器中保存这些元素 redisBloomUtils.bfmadd("colorBloom",colors); //定义一个要判断的字符 String element="black"; //输出判断结果 System.out.println("判断"+ element +"是否在布隆过滤器中:"+ redisBloomUtils.bfexists("colorBloom",element)); }准备了支持布隆过滤器的Redis
seckill.timer.job包中,新建SeckillBloomInitialJob
package cn.tedu.mall.seckill.timer.job;
import cn.tedu.mall.seckill.mapper.SeckillSpuMapper;import cn.tedu.mall.seckill.utils.RedisBloomUtils;import cn.tedu.mall.seckill.utils.SeckillCacheUtils;import org.quartz.Job;import org.quartz.JobExecutionContext;import org.quartz.JobExecutionException;import org.springframework.beans.factory.annotation.Autowired;
import java.time.LocalDate;
//将spuId保存到布隆过滤器中public class SeckillBloomInitialJob implements Job { @Autowired private RedisBloomUtils redisBloomUtils; @Autowired private SeckillSpuMapper seckillSpuMapper; @Override public void execute(JobExecutionContext context) throws JobExecutionException { //首先确定保存布隆过滤器的批次的key //我们这里设计添加两个秒杀批次的布隆过滤器 //避免两个批次之间瞬间的空档期 //而且也允许让用户看到下一个批次的商品 //key可能是这样:“spu:bloom:filter:2023-03-06” String bloomTodayKey = SeckillCacheUtils.getBloomFilterKey(LocalDate.now()); String bloomTomorrowKey = SeckillCacheUtils.getBloomFilterKey(LocalDate.now().plusDays(1)); //到数据库中根据秒杀时间查询对应的SpuId集合 Long[] spuIds = seckillSpuMapper.findAllSeckillSpuIds(); //布隆过滤器支持String[]数组类型的参数,将数据保存到redis中 String[] spuIdStrs = new String[spuIds.length]; //将spuIds中的数据转为String类型,赋值到spuIdStrs for (int i = 0; i < spuIds.length; i++) { spuIdStrs[i]=spuIds[i]+""; } //spuIdStrs保存到布隆过滤器中 //实际开发中,每个批次的spuId是不一样的,这里是学习阶段使用了相同的spuId redisBloomUtils.bfmadd(bloomTodayKey,spuIdStrs); redisBloomUtils.bfmadd(bloomTomorrowKey,spuIdStrs); System.out.println("将两个批次的布隆过滤器加载完成"); }}下面在seckill.timer.config包中添加布隆过滤器相关的调度配置
继续在QuartzConfig类中添加绑定信息
//定义Trigger @Bean public Trigger initSeckillTrigger(){ log.info("预热触发器运行"); CronScheduleBuilder cronScheduleBuilder = CronScheduleBuilder.cronSchedule("0 0/1 * * * ?"); return TriggerBuilder.newTrigger() .forJob(initJobDetail()) .withIdentity("initialTrigger") .withSchedule(cronScheduleBuilder) .build(); }
//布隆过滤器 @Bean public JobDetail seckillBloomJobDetail(){ log.info("加载布隆过滤器"); return JobBuilder.newJob(SeckillBloomInitialJob.class) .withIdentity("SeckillBloom") .storeDurably() .build(); } @Bean public Trigger seckillBloomTrigger(){ log.info("布隆过滤器触发器运行"); //方便看效果,每分钟执行一次 //实际开发中根据秒杀批次定义布隆过滤器的运行时间 CronScheduleBuilder cronScheduleBuilder = CronScheduleBuilder.cronSchedule("0 0/1 * * * ?"); return TriggerBuilder.newTrigger() .forJob(seckillBloomJobDetail()) .withIdentity("SeckillBloomTrigger") .withSchedule(cronScheduleBuilder) .build(); }下面可以测试布隆过滤器的运行
保证虚拟机启动正常
启动product\seckill
需要修改表的开始和结束时间的字段名,让代码和数据库保持一致即可
现在Redis中保存了布隆过滤器
我们需要用户根据SpuId查询商品时,进行判断和过滤
如果spuId不存在,就应该发生异常,给出提示
SeckillSpuServiceImpl类中getSeckillSpu进行修改,添加布隆过滤器的判断
@Autowired private RedisBloomUtils redisBloomUtils; //根据spuId查询spu详情 @Override public SeckillSpuVO getSeckillSpu(Long spuId) { //先判断当前spuId是否在布隆过滤器中 String bloomTodayFilter = SeckillCacheUtils.getBloomFilterKey(LocalDate.now()); log.info("当前批次的布隆过滤器key为:{}",bloomTodayFilter); //如果不存在。直接抛出异常 if(!redisBloomUtils.bfexists(bloomTodayFilter,spuId+"")){ //进入这里表示布隆过滤器没有这个spuId,防止缓存穿透,抛出异常 throw new CoolSharkServiceException(ResponseCode.NOT_FOUND,"您访问的商品不存在(测试:布隆过滤器)"); } //声明返回值类型对象 SeckillSpuVO seckillSpuVO = new SeckillSpuVO(); ...... }启动product\seckill
查询SpuId如果不存在于秒杀表中,是否能被过滤器拦截
所谓配置中心:将项目需要的配置信息保存在配置中心,需要读取时直接从配置中心读取,方便配置管理的微服务工具
我们可以将部分yml文件的内容保存在配置中心
一个微服务项目有很多子模块,这些子模块可能在不同的服务器上,如果有一些统一的修改,我们要逐一修改这些子模块的配置,由于他们是不同的服务器,所以修改起来很麻烦
如果将这些子模块的配置集中在一个服务器上,我们修改这个服务器的配置信息,就相当于修改了所有子模块的信息,这个服务器就是配置中心
使用配置中心的原因就是能够达到高效的修改各个模块配置的目的
Nacos即可以做注册中心,也可以做配置中心
Nacos做配置中心,支持各种格式\类型的配置文件,比如:properties、yaml、json、sml、txt等等
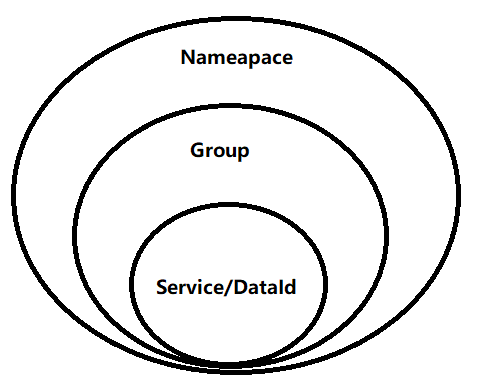
namespace:命名空间
group:分组
Service/DataId:具体数据
namespace是Nacos提供的最大的数据结构
一个Nacos可以创建多个命名空间
一个命令空间可以包含多个group
一个group可以包含多条配置信息
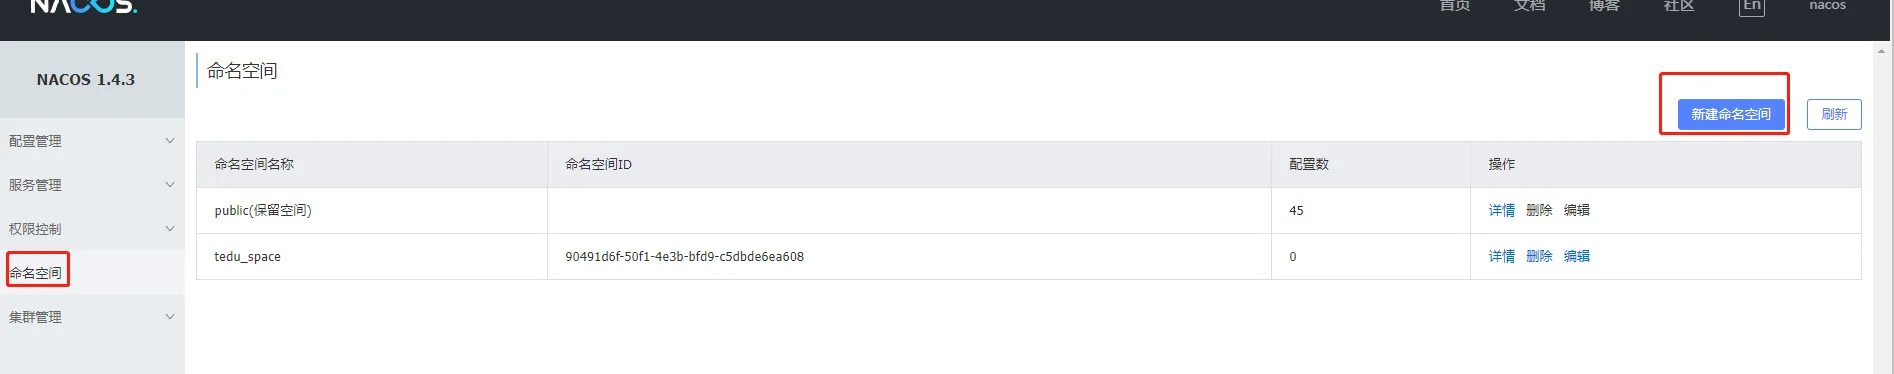
Nacos默认的命令空间—public,不能删除和修改
自己创建的命名空间可以删除和修改
添加命名空间后,我们在Nacos中注册的服务或添加的配置就可以指定命名空间了
多个命名空间可以隔离项目,每个项目使用自己的命名空间,互不干扰
一个命名空间中可以有多个分组,进行进一步分离
如果不想指定分组,我们可以用默认的分组: DEFAULT_GROUP
确定命名空间和分组之后,就可以添加服务或配置了
以cart项目为例:把连接数据库的配置从项目的配置文件中移动到配置中心
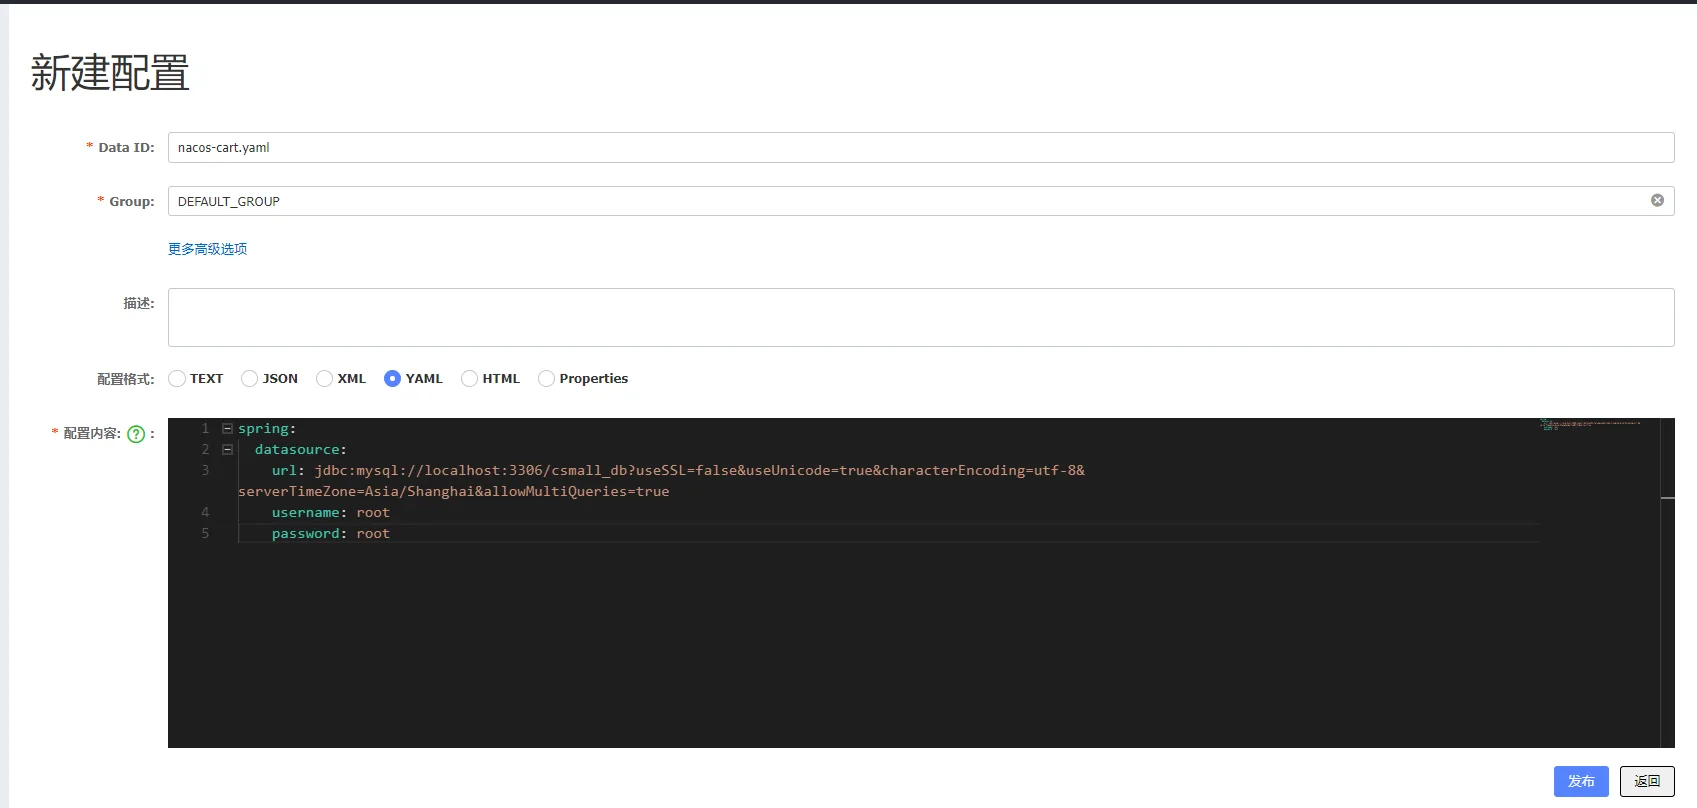
项目中的该配置注释起来
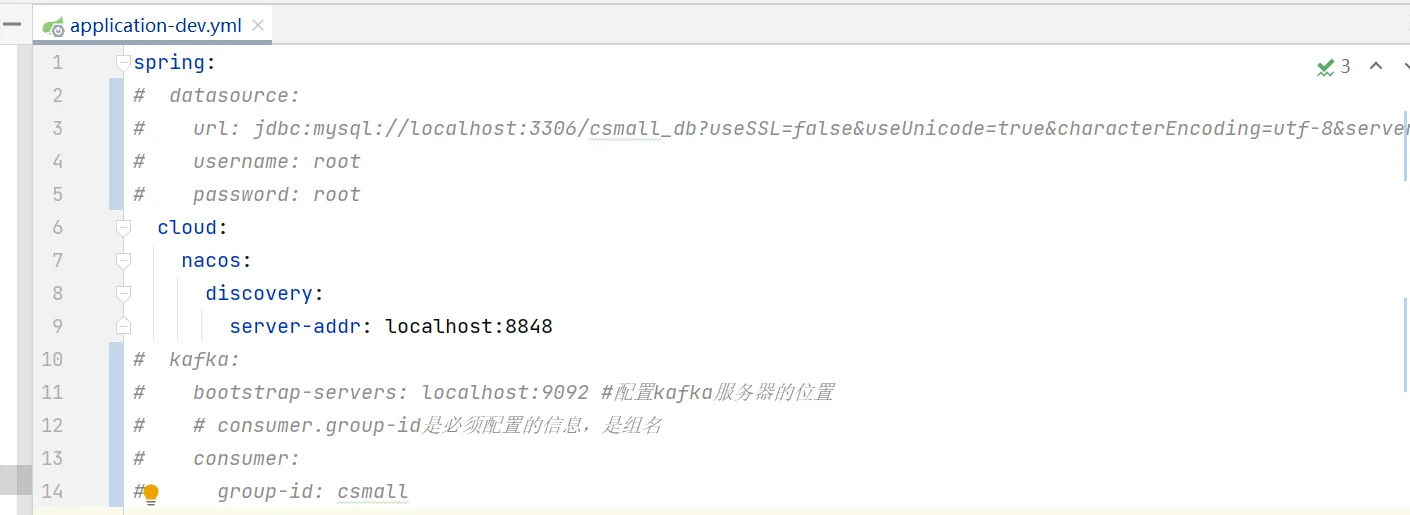
项目从配置中心读取配置
添加配置中心的依赖
<!--nacos配置中心的依赖--> <dependency> <groupId>com.alibaba.cloud</groupId> <artifactId>spring-cloud-starter-alibaba-nacos-config</artifactId> </dependency> <!--支持SpringCloud加载系统配置的依赖--> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-bootstrap</artifactId> </dependency>项目中我们使用application.properties和application.yml文件,这两种配置文件加载是有顺序的
先加载yml
后加载properties
如果两个配置文件同时设置了同一个属性,后加载的覆盖先加载的
我们项目中除了主配置文件外,还有profile文件,我们通过在主文件的配置激活,所以profile文件是后加载的文件,同样会发生同名属性的覆盖
除此之外还有一种文件是bootstrap文件,是加载系统配置的文件,优先于所有文件加载
由于连接数据库的配置现在不在项目中,所以当项目启动时,多番连接依旧没有找到数据库,会连接失败;数据库连接配置配置在了配置中心中,所以我们要先连接到配置中心去读取配置文件
创建bootstarp.yml文件
spring: cloud: nacos: discovery: server-addr: localhost:8848 config: username: nacos password: nacos namespace: public group: DEFAULT_GROUP # 指定加载配置文件的格式以及对应文件 file-extension: yaml prefix: nacos-carthttps://gitee.com/mingxuchn/csmall-mobile-repo.git